转换前先准备什么
TXT 文件
支持 UTF-8、GB18030 / GBK、Big5 等常见中文编码,单文件上限 50 MB。
目录判断
确认哪些文本行是真正章节或分卷,避免错误标题进入 EPUB 导航。
书籍信息
可填写书名、作者、简介并选择 JPG、PNG 或 WebP 封面。
从 TXT 到 EPUB 的完整步骤
1. 导入 TXT 并核对编码
选择文件后查看编码识别结果;预览乱码时先手动切换编码。
2. 扫描章节标题
NovelLint 从原文中建立章节候选和文档风格画像。
3. 审核最终目录
确认真正的章节和分卷,排除正文误识别,并手动补充漏掉的标题。
4. 检查编号异常
处理跳号、重复编号、倒序和新卷重置,避免错误顺序进入阅读导航。
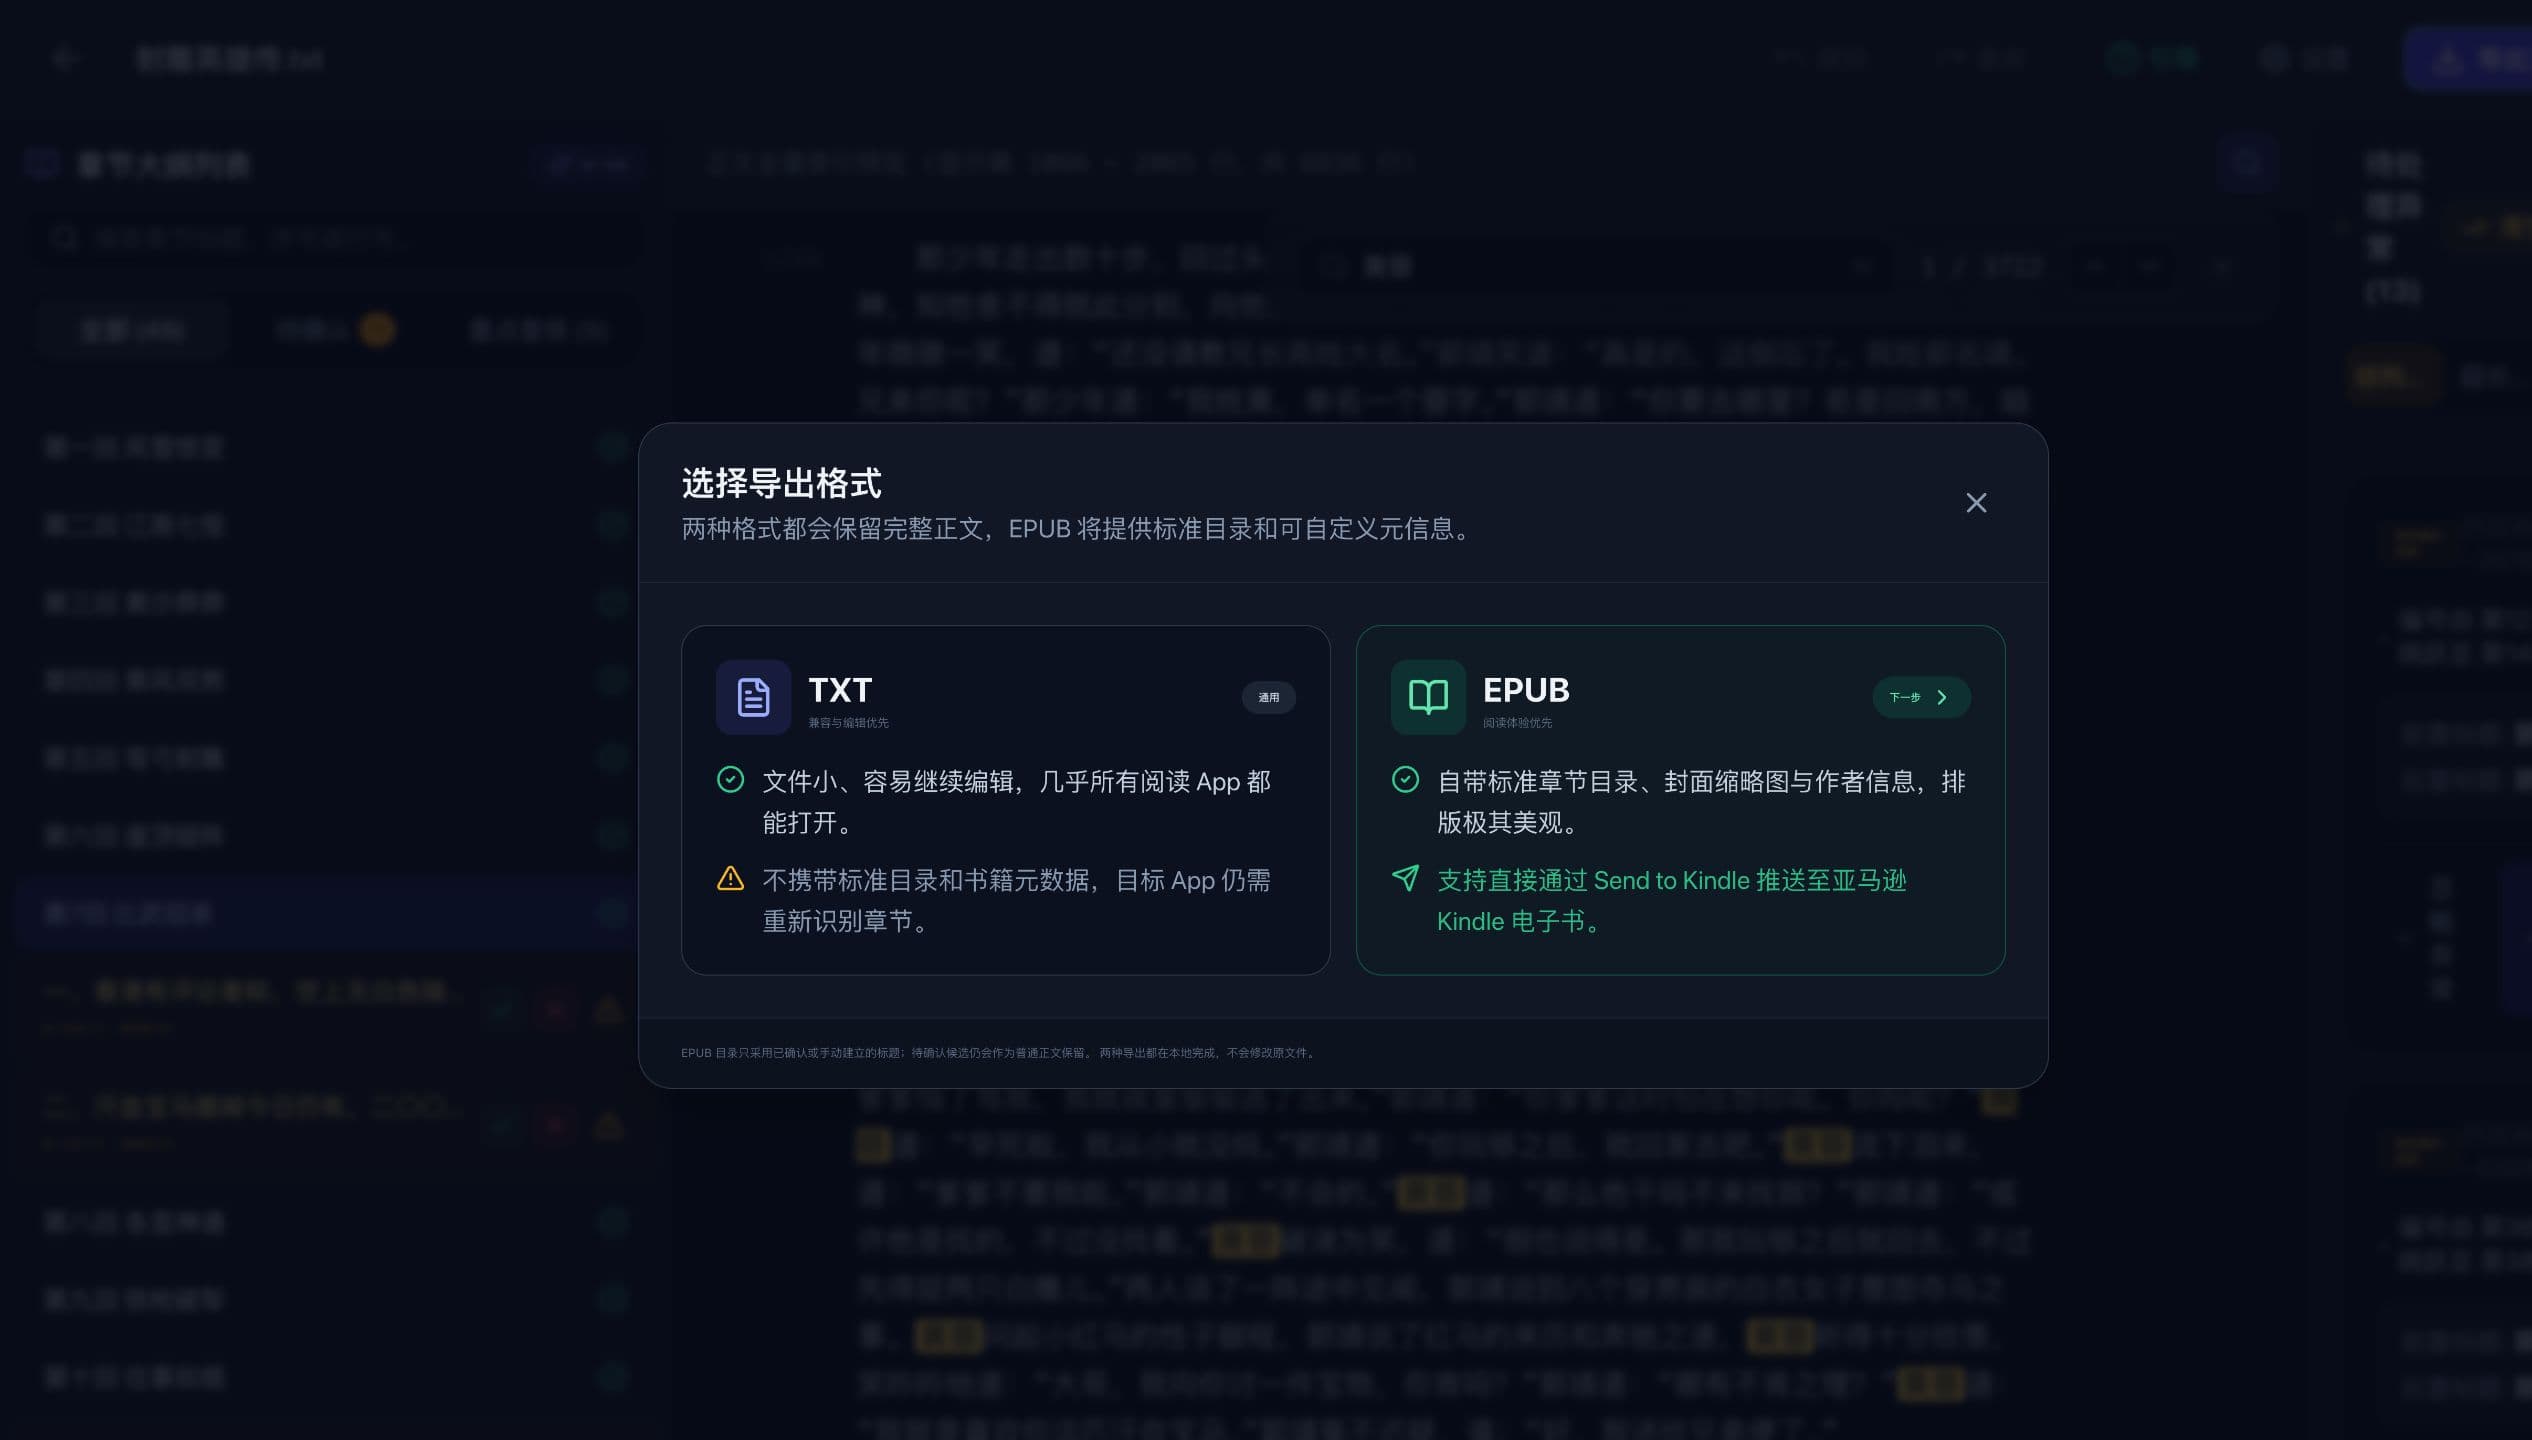
5. 选择 EPUB 导出
填写书名、作者、简介和封面;未上传封面时会生成文字封面。
6. 保存并在阅读器检查
打开生成的 EPUB,重点检查目录跳转、章节顺序、封面和元信息。
生成的 EPUB 包含什么
电子书结构
- EPUB 3 导航目录
- 兼容 EPUB 2 阅读器的 NCX 目录
- 按章节排列的阅读顺序
- 书名、作者、简介和封面
正文处理
- 保留完整正文内容
- 应用已确认的标题编辑和人工文本修改
- 未确认标题继续作为普通正文
- 所有文件在当前浏览器本地生成
只有状态为“已确认”或“手动建立”的标题会进入 EPUB 目录。这个限制用于防止低置信度候选直接污染最终导航,因此导出前的人工审核不能省略。
它不是原 EPUB 的无损重制
NovelLint 的导出目标是生成结构清晰、可回流阅读的 EPUB。若输入本身是 EPUB,原书 CSS、字体、图片和复杂版式不会原样保留;从 TXT 生成时也不会凭空恢复原书排版资源。
如果目录识别还不稳定,请先完成TXT 自动识别章节和章节编号异常检查,再执行 EPUB 导出。
用自己的小说检查一遍
TXT 解码、章节扫描、目录审核与 EPUB 生成默认都在当前浏览器本地完成。
打开 NovelLint