自动识别章节,实际包含四个步骤
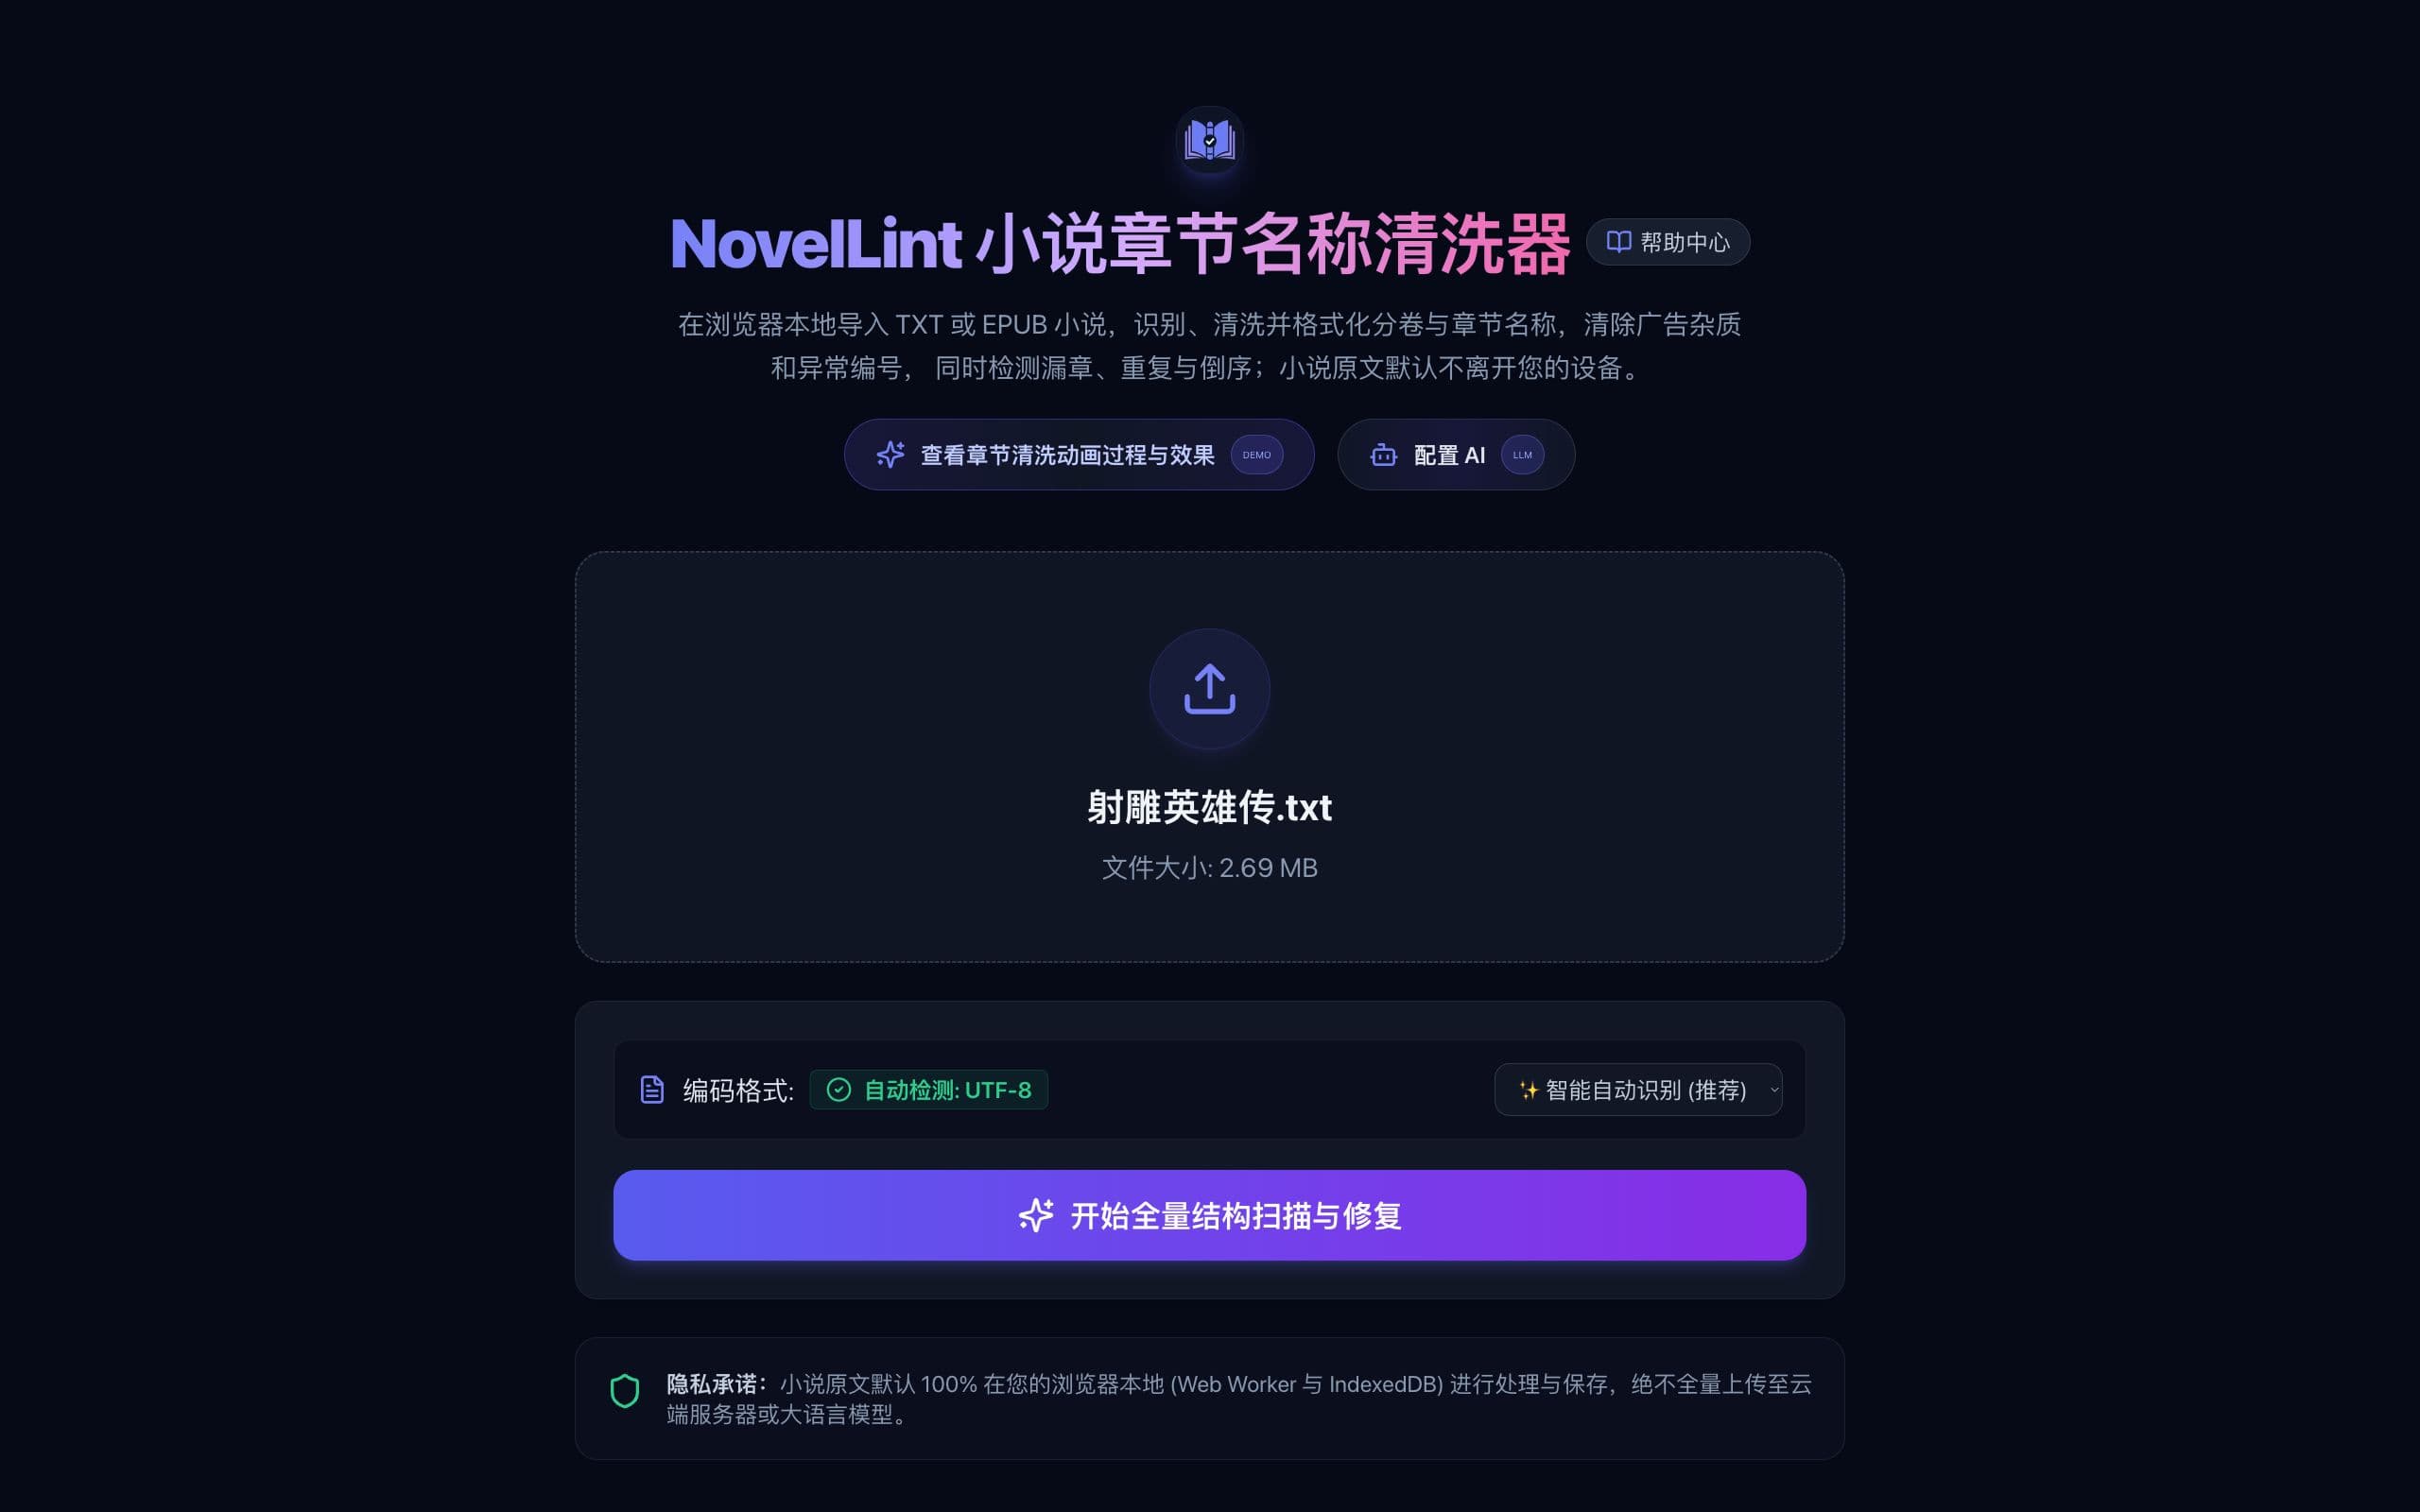
1. 确认文本编码
先把 TXT 按 UTF-8、GB18030 / GBK 或 Big5 正确解码;文字没有读对,后续规则也无法可靠判断标题。
2. 扫描章节候选
从独立文本行中寻找“第十二章”“12章”“序章”“番外”等标题结构,并保留上下文证据。
3. 检查编号序列
把可解析的章节编号放进前后序列,辅助识别跳号、重复和可能的误判。
4. 人工确认目录
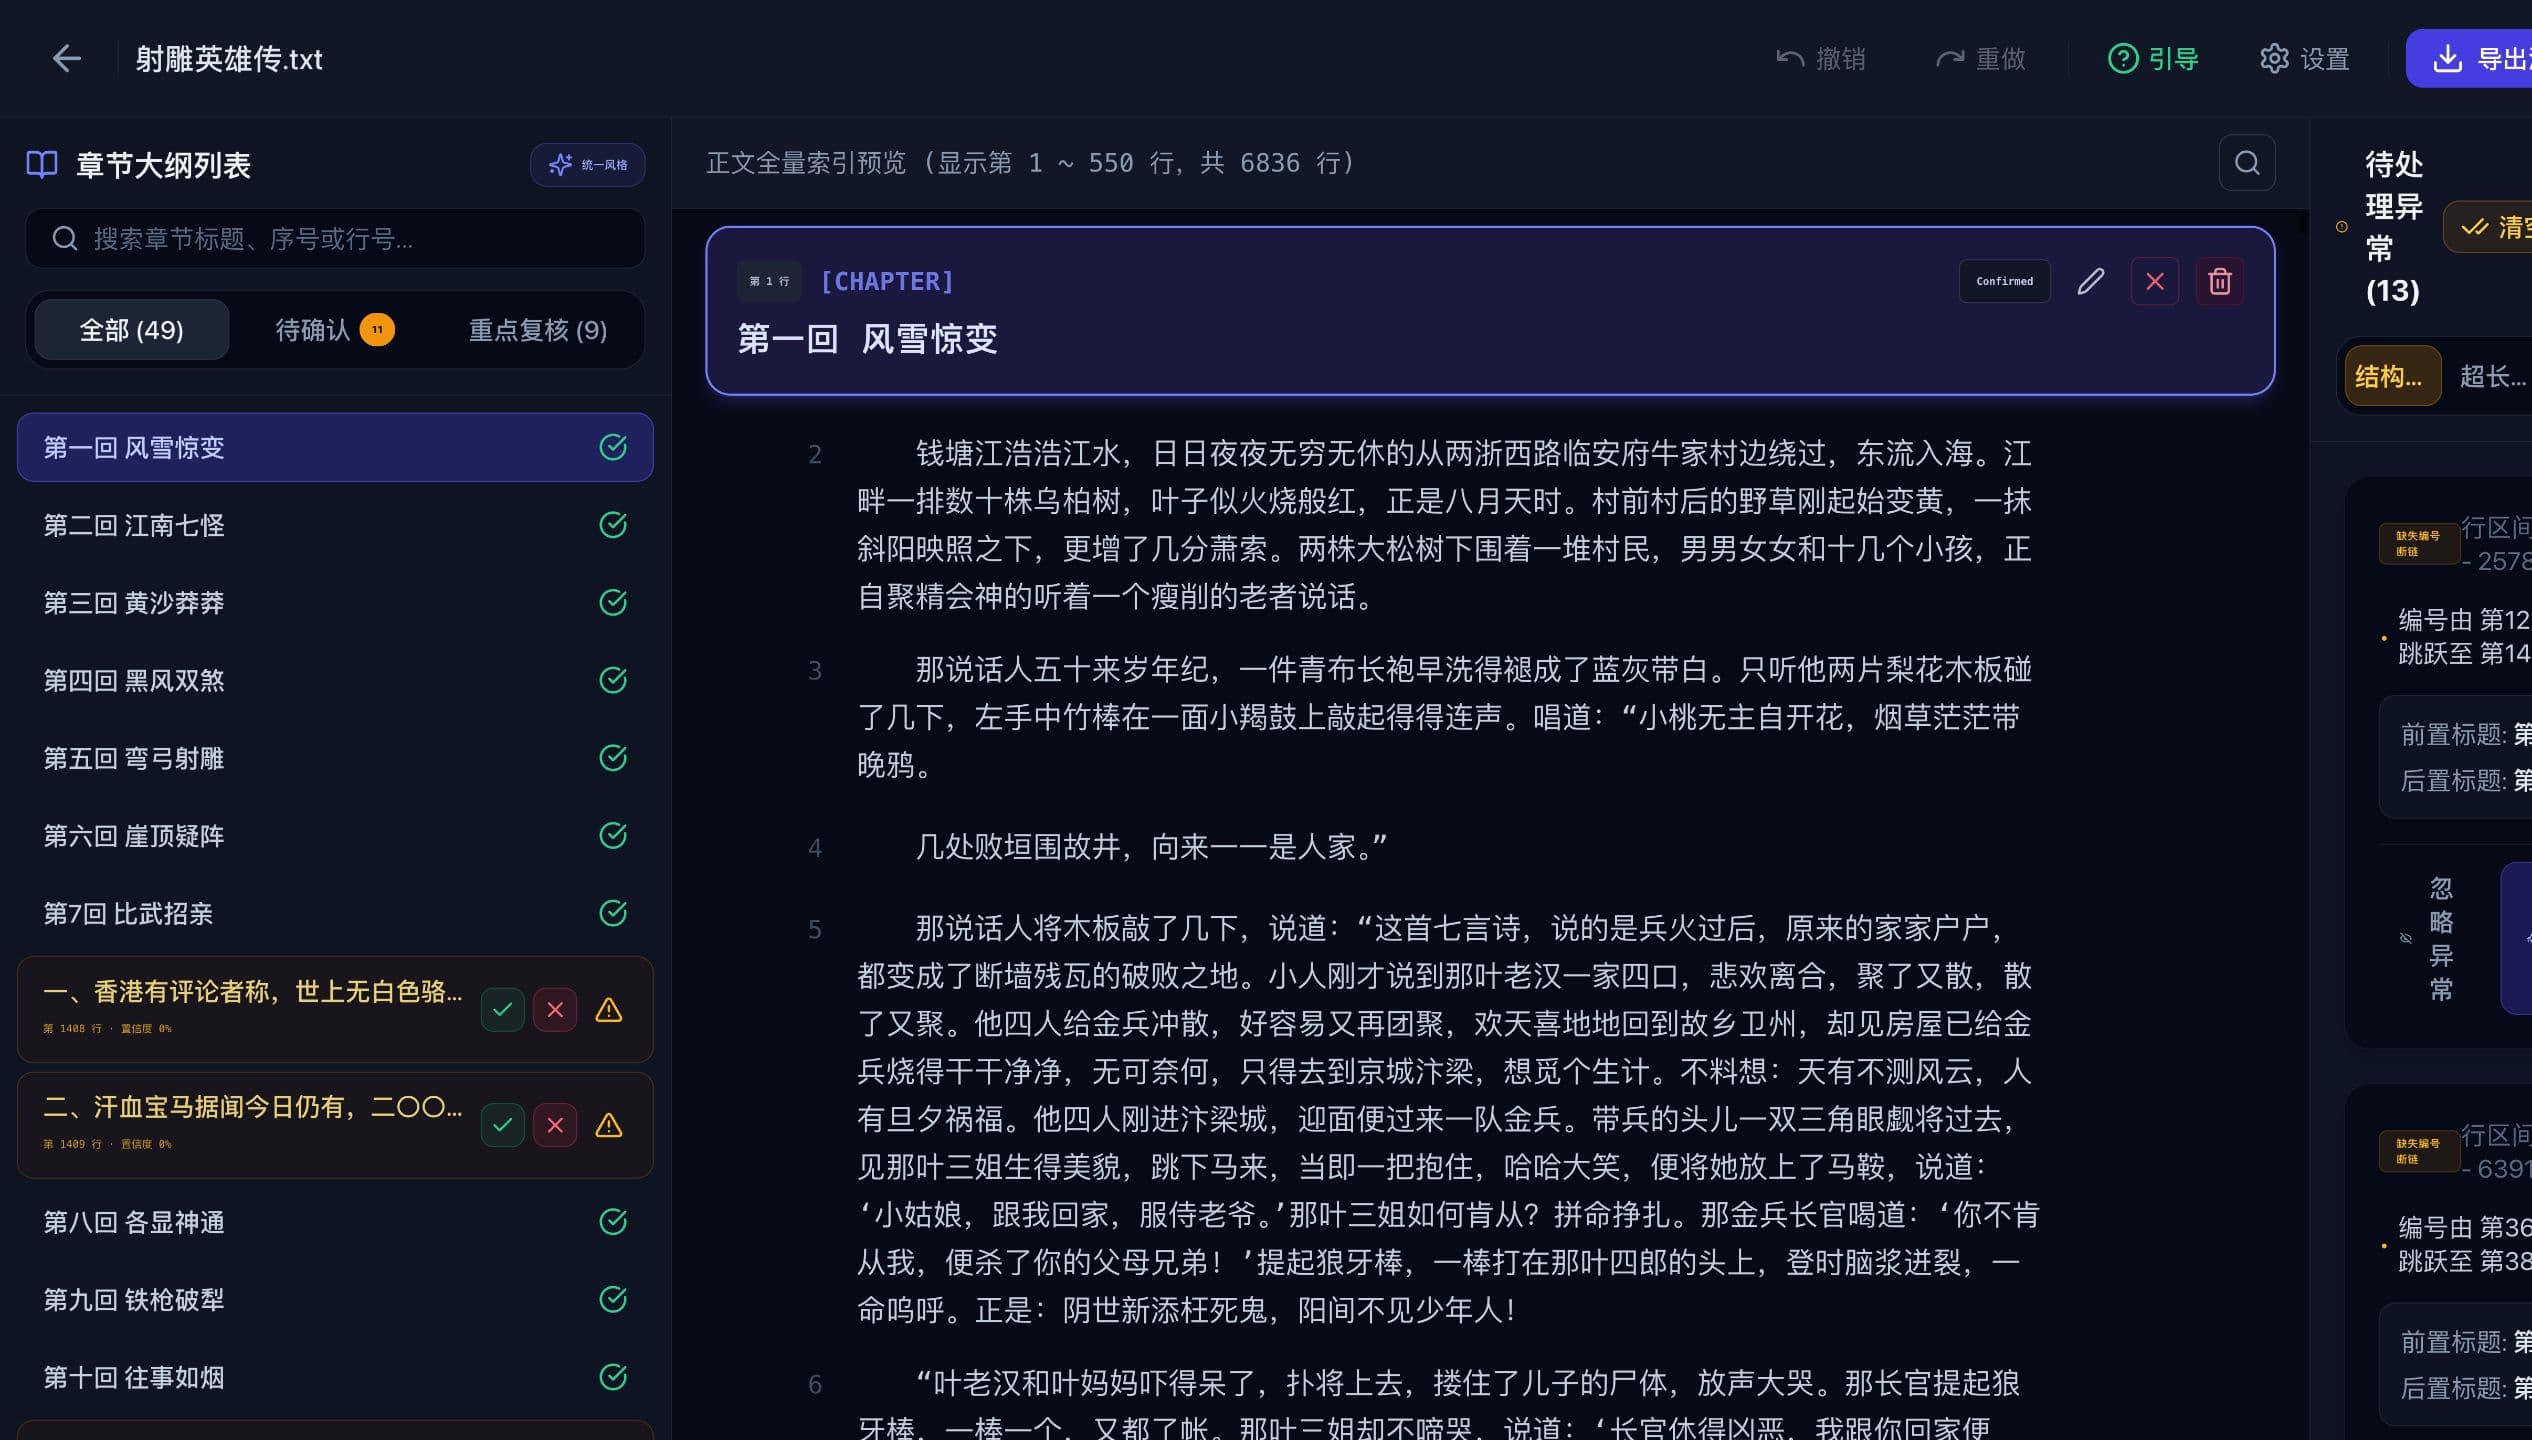
在工作区逐项确认、排除或编辑候选;只有已确认或手动建立的标题才会作为最终目录来源。
自动识别输出的是“章节候选”,不是不可更改的最终答案。特殊排版、正文中提到“第 X 章”或目录页重复标题都可能需要人工复核。
哪些章节格式更容易识别
| 类型 | 示例 | 处理方式 |
|---|---|---|
| 标准章节 | 第十二章 初见 | 解析中文编号和章节单位 |
| 无“第”前缀 | 12章 重逢 | 结合行位置和前后文评分 |
| 分卷标题 | 第一卷 风起 | 作为卷边界参与目录组织 |
| 特殊章节 | 序章 / 楔子 / 番外 | 按特殊章节关键词识别 |
识别失败时怎么处理
- 先确认 TXT 文字编码正确;乱码会同时破坏标题文本和编号识别。
- 在左侧“待确认”和“重点复核”中寻找低置信度候选,不要只看已确认目录。
- 标题被当成正文时,可在对应行手动建立章节或分卷标题。
- 正文句子被误认成章节时,将候选排除;原文仍会保留。
- 同一本书的标题风格混用时,先完成候选确认,再使用统一标题样式功能。
下一步:检查目录是否连续
章节识别完成后,不要只看目录数量。继续检查编号是否跳号、相邻章节是否重号,以及新卷开始时的编号重置是否合理。
阅读“小说缺章、重复章怎么检测”教程 →用自己的小说检查一遍
TXT 解码、章节扫描、目录审核与 EPUB 生成默认都在当前浏览器本地完成。
打开 NovelLint